동적 계획법 (Dynamic Programming)
한눈에 보기
겹치는 부분 문제와 최적 부분 구조를 전제로 부분 문제의 답을 저장해 재사용하는 동적 계획법을 다룬다. 하향식과 상향식 비교, 문제 풀이 단계, 배낭 문제 구현을 정리한다.
최종 업데이트 2026.09.17
동적 계획법(Dynamic Programming, DP)은 큰 문제를 작은 문제로 쪼개 풀되, 한 번 푼 작은 문제의 답은 저장해두고 재사용하는 방법이다. 이름이 거창하지만 핵심은 "같은 계산을 두 번 하지 않는다" 하나뿐이다.
코딩테스트에서 가장 막막해하는 주제이기도 하다. 다른 알고리즘은 절차가 정해져 있는데 DP는 문제마다 점화식을 직접 세워야 하기 때문이다. 이 글은 DP가 언제 성립하는지, 점화식을 어떻게 찾는지에 초점을 맞춘다.
DP가 성립하는 두 가지 조건
아무 문제나 DP로 풀리지는 않는다. 두 조건이 모두 필요하다.
- 최적 부분 구조: 큰 문제의 답이 작은 문제들의 답으로 만들어진다. "n번째 계단까지 오는 방법의 수"는 "n−1번째까지의 방법 수"와 "n−2번째까지의 방법 수"의 합이다.
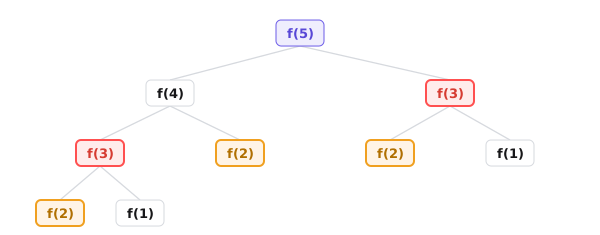
- 중복 부분 문제: 같은 작은 문제가 여러 번 등장한다. 이게 없으면 저장해봐야 재사용할 일이 없어서 그냥 분할 정복이다.
병합 정렬도 쪼개서 풀지만 DP가 아니다. 쪼개진 조각들이 서로 겹치지 않아서 저장할 이유가 없기 때문이다. 반면 피보나치는 같은 값을 지겹도록 반복 계산한다.
두 가지 구현 방식
같은 점화식을 푸는 방법이 두 가지 있다. 어느 쪽을 써도 되지만 상황에 따라 유불리가 갈린다.
| 구분 | 메모이제이션 (Top-down) | 타뷸레이션 (Bottom-up) |
|---|---|---|
| 방향 | 큰 문제에서 재귀로 내려감 | 작은 문제부터 표를 채워 올라감 |
| 구현 | 재귀 + 캐시 (점화식 그대로) | 반복문 + 배열 |
| 장점 | 필요한 부분만 계산, 점화식과 코드가 닮음 | 재귀 오버헤드 없음, 스택 걱정 없음 |
| 단점 | 재귀 깊이 초과 위험, 함수 호출 비용 | 안 쓰는 값까지 다 계산 |
| 추천 | 점화식은 알겠는데 순서가 헷갈릴 때 | 계산 순서가 명확할 때 (대부분) |
구현 코드 예시
from functools import lru_cache

# 1) 메모이제이션 — 점화식을 그대로 옮기고 캐시만 붙인다
@lru_cache(maxsize=None)
def fib_memo(n):
    if n <= 1:
        return n
    return fib_memo(n - 1) + fib_memo(n - 2)


# 2) 타뷸레이션 — 작은 값부터 표를 채운다
def fib_tab(n):
    if n <= 1:
        return n
    dp = [0] * (n + 1)
    dp[1] = 1
    for i in range(2, n + 1):
        dp[i] = dp[i - 1] + dp[i - 2]
    return dp[n]


# 3) 공간 최적화 — 직전 두 값만 있으면 되므로 배열이 필요 없다
def fib_opt(n):
    a, b = 0, 1
    for _ in range(n):
        a, b = b, a + b
    return a
3번처럼 필요한 이전 상태만 남기고 배열을 버리는 최적화는 DP에서 자주 쓴다. 2차원 DP에서 직전 행만 참조한다면 2행짜리 배열로 줄일 수 있고, 조건이 맞으면 1차원으로도 가능하다. 메모리 제한이 빡빡한 문제에서 이 최적화가 답이 되는 경우가 많다.
대표 문제 — 0/1 배낭
DP의 전형을 보여주는 문제다. 무게와 가치가 있는 물건들이 있고, 배낭의 용량을 넘지 않게 담아 가치의 합을 최대로 만든다. 각 물건은 넣거나 안 넣거나 둘 중 하나다.
상태를 dp[i][c] = "앞에서 i개의 물건만 고려하고 용량이 c일 때의 최대 가치"로 잡으면, 각 물건마다 선택지는 두 가지뿐이다.
def knapsack(weights, values, capacity):
    n = len(weights)
    dp = [[0] * (capacity + 1) for _ in range(n + 1)]

    for i in range(1, n + 1):
        w, v = weights[i - 1], values[i - 1]
        for c in range(capacity + 1):
            dp[i][c] = dp[i - 1][c]                          # i번째를 안 넣는 경우
            if c >= w:                                       # 넣을 수 있다면
                dp[i][c] = max(dp[i][c], dp[i - 1][c - w] + v)   # 넣는 경우와 비교

    return dp[n][capacity]


def knapsack_1d(weights, values, capacity):
    """직전 행만 쓰므로 1차원으로 줄일 수 있다. 단 용량은 반드시 역순으로."""
    dp = [0] * (capacity + 1)
    for w, v in zip(weights, values):
        for c in range(capacity, w - 1, -1):     # 역순 — 같은 물건을 두 번 담는 것을 막는다
            dp[c] = max(dp[c], dp[c - w] + v)
    return dp[capacity]
1차원 버전에서 용량을 역순으로 도는 이유가 중요하다. 정순으로 돌면 방금 갱신한 dp[c - w]를 다시 읽어서, 같은 물건을 여러 번 담은 결과가 된다. 그건 0/1 배낭이 아니라 무한 배낭 문제의 답이다.
점화식은 어떻게 세우는가
DP 문제를 만나면 이 순서로 생각한다.
- 상태를 정의한다. "dp[i]가 무엇을 의미하는가"를 한 문장으로 쓴다. 여기서 막히면 뒤가 다 막힌다. 보통 "i번째까지 봤을 때의 최적값" 형태로 시작한다.
- 선택지를 나열한다. i번째에서 할 수 있는 행동이 무엇인가. 배낭이면 "넣는다 / 안 넣는다" 두 가지다.
- 각 선택지를 이전 상태로 표현한다. "안 넣으면 dp[i−1][c] 그대로", "넣으면 dp[i−1][c−w] + v".
- 초기값과 계산 순서를 정한다. dp[0]은 무엇인가. 어떤 순서로 채워야 참조하는 값이 이미 확정되어 있는가.
상태 정의가 90%다. 점화식이 안 나오면 대부분 상태를 잘못 잡은 것이므로, 식을 붙들고 씨름하지 말고 상태 정의로 돌아가는 편이 빠르다.
자주 하는 실수
- 상태를 정의하지 않고 코드부터 짠다. "dp[i]가 무엇인지" 말로 설명할 수 없으면 그 코드는 십중팔구 틀렸다.
- 계산 순서를 잘못 잡는다. dp[i]를 구할 때 참조하는 값이 아직 안 채워져 있으면 초기값 0을 읽어 조용히 틀린다. 1차원 배낭의 역순 순회가 대표적인 함정이다.
- 초기값을 0으로만 둔다. 최솟값을 구하는 DP라면 초기값이 무한대여야 한다. "도달 불가능"과 "값이 0"을 구분해야 하는 문제도 많다.
- 메모이제이션에서 캐시 키를 빠뜨린다. 상태가 두 개인데 하나만 키로 쓰면 다른 상태의 답을 잘못 재사용한다.
lru_cache는 인자 전체를 키로 쓰므로 상태를 전부 인자로 넘겨야 한다. - 재귀 깊이를 넘긴다. 메모이제이션은 n이 크면
RecursionError가 난다.sys.setrecursionlimit을 올리거나 타뷸레이션으로 바꾼다. - DP가 아닌 문제에 DP를 쓴다. 중복 부분 문제가 없으면 저장이 낭비다. 반대로 그리디로 풀리는 문제를 DP로 풀면 메모리 초과가 날 수 있다.
면접에서 이렇게 물어본다
- 동적 계획법이 성립하기 위한 두 조건을 설명해 보라.
- 분할 정복과 동적 계획법의 차이는 무엇인가.
- 메모이제이션과 타뷸레이션의 장단점을 비교해 보라.
- 그리디와 DP는 어떤 기준으로 구분하는가.
- 0/1 배낭 문제의 점화식을 세워 보라.
- DP의 공간 복잡도를 줄이는 방법을 예를 들어 설명해 보라.
- 1차원 배낭에서 용량을 역순으로 순회해야 하는 이유는 무엇인가.
알고리즘에서 같이 읽기
- 이분 탐색 (Binary Search)정렬된 배열에서 탐색 범위를 절반씩 줄여 O(log n)에 값을 찾는 이분 탐색의 원리와 동작 과정을 그림으로 정리했다. lower bound와 upper bound, 코딩테스트 단골인 파라메트릭 서치와 회전 정렬 배열, 구현 코드와 자주 하는 실수까지 다룬다.
- 비트마스크 (Bitmask)정수의 각 비트로 집합의 포함 여부를 표현하는 비트마스크 기법을 다룬다. 기본 비트 연산 정리, 부분집합 열거, 외판원 순회 동적 계획법 구현과 주의점을 정리한다.
- DFS와 BFS (Depth First Search, Breadth First Search)그래프의 모든 정점을 방문하는 DFS와 BFS의 원리와 방문 순서 차이를 스택과 큐로 설명하고, O(V + E) 복잡도, 구현 코드, 문제 유형별 선택 기준을 정리한다.
- 다익스트라 알고리즘 (Dijkstra's Algorithm)음수 간선이 없는 그래프에서 한 정점으로부터의 최단 거리를 구하는 다익스트라 알고리즘의 그리디 원리, 우선순위 큐 구현, 복잡도 비교와 한계를 정리한다.
이 개념, 내 코드에서는 어떻게 물어볼까요
데브핏(DevFit)에 채용공고 URL을 붙여 넣고 레포지토리를 연결하면, 내가 쓴 커밋에서 예상 질문과 어필 포인트를 만듭니다. 하루 10회까지 무료입니다. 합불 판정이나 지원자 랭킹은 만들지 않고, 최종 판단은 사람이 합니다.
공고 넣고 시작하기